¿Quién construye el próximo GitHub? Código, IA y poder
Ai SecurityTabla de contenidos
GitHub es una plataforma para almacenar, desarrollar y publicar software en colaboración. Su base es Git, una herramienta de control de versiones: registra los cambios en archivos, permite mantener ramas de desarrollo paralelas y ayuda a reunir distintas versiones del trabajo. Git aporta el fundamento técnico. GitHub añade la colaboración mediante incidencias, debates, solicitudes de incorporación de cambios y procesos automatizados.
Git nació en 2005 durante el desarrollo del núcleo Linux. GitHub se fundó en 2008 y abrió al público el 10 de abril de 2008. Diez años después, Microsoft compró la empresa por 7.500 millones de dólares y anunció el cierre de la adquisición el 26 de octubre de 2018. Aquel espacio para desarrolladores se convirtió en infraestructura central del software. Git, GitHub, Microsoft
En 2026 parece que una de cada dos personas ajenas al desarrollo tradicional también tiene cuenta en GitHub. Una pequeña aplicación, un panel personal, una herramienta de IA que pide conectar un repositorio. Es una impresión deliberadamente exagerada, no una estadística sobre quienes no son desarrolladores. Sin embargo, el cambio de fondo importa: crear software resulta más accesible y la infraestructura que lo sostiene soporta nuevas cargas.
Por eso me interesa quién construirá el próximo GitHub. Anthropic ha rediseñado su control de versiones interno. Cloudflare ofrece componentes para nuevas plataformas Git. Al mismo tiempo, la fiabilidad de GitHub se cuestiona públicamente. Está en juego mucho más que un botón para fusionar cambios: quién controla el lugar donde se crea, revisa y lleva a producción el software.
Cuando los usuarios se convierten en creadores de software
El cambio empezó antes de este año. El informe Octoverse 2025 de GitHub ya contabilizaba más de 180 millones de desarrolladores y más de 36 millones de nuevos usuarios en un año. Según GitHub, cerca del 80 % de los nuevos desarrolladores usaban Copilot durante su primera semana. Son datos del proveedor, no una demostración de que la IA haya causado todo el crecimiento. Sí muestran hasta qué punto empezar en GitHub se vincula con las herramientas de IA.
Antes, para crear una pequeña utilidad había que aprender suficiente programación como para conseguir un comienzo útil. Hoy se puede describir una idea y desarrollarla paso a paso con un agente de programación. Los conocimientos siguen siendo necesarios, especialmente con datos, permisos y sistemas en producción. Aun así, la distancia entre una idea y un primer programa funcional se ha reducido considerablemente.
Veo un enorme potencial para el código abierto: mejorar documentación, añadir pruebas, investigar fallos, facilitar interfaces y retomar ideas abandonadas. Son formas concretas de acelerar el desarrollo. No prueban una mejora de calidad en todos los proyectos. Un repositorio adicional no equivale a software mantenido, y otra solicitud de cambios también puede dar más trabajo a quien mantiene el proyecto.
Me interesa menos cuántas líneas produce un agente que cuántas pueden comprenderse, verificarse y mantenerse. Cuando el código llega más deprisa, el cuello de botella se desplaza hacia las personas y los sistemas que deciden qué cambios deben permanecer.
El árbol de Navidad de la página de estado
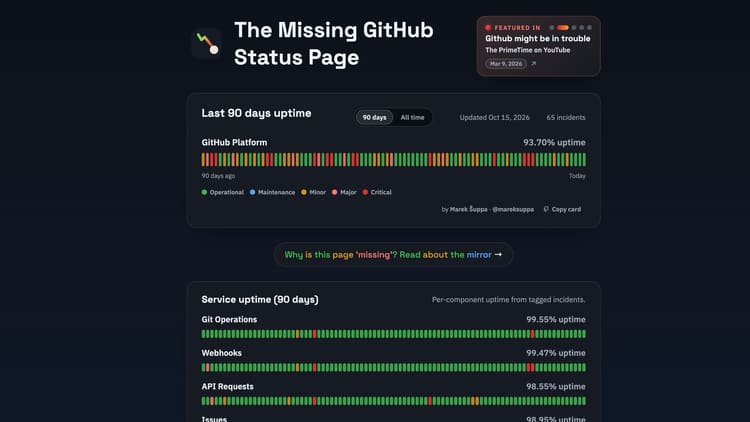
La imagen de cabecera muestra The Missing GitHub Status Page, de Marek Šuppa. La captura del 15 de octubre de 2026 indica 65 incidentes y un 93,70 % de disponibilidad de la plataforma durante 90 días. Git Operations muestra, en cambio, un 99,55 %. Son cifras de esa captura, no mediciones actuales realizadas por mí.
Esta página no oficial reconstruye intervalos a partir de informes públicos y combina interrupciones superpuestas. La cifra de plataforma agrega distintos servicios. No significa que las clonaciones Git, las solicitudes de cambios y Actions fallasen simultáneamente para todos en cada incidente. El 93,70 % no se traduce sin más en «GitHub estuvo completamente desconectado el 6,30 % del tiempo». Su interpretación depende de la agregación y los incidentes incluidos.
Aun así, la imagen toca un punto sensible. Una plataforma de versiones forma parte de la cadena de producción. Una revisión inaccesible, una compilación bloqueada o una API averiada pueden retrasar una publicación aunque el código esté completo en local. Para el proceso afectado importa que funcione toda la cadena.
El gráfico tampoco demuestra que la IA causara esos incidentes. Ayuda a entender el interés por alternativas. Las causas de cada interrupción deben evaluarse con su correspondiente informe.
Por qué hay que distinguir Git de GitHub
Una caída de GitHub no demuestra por sí sola un fallo del modelo de datos de Git. Con una copia local completa puedo registrar cambios, comparar versiones y trabajar en ramas sin que el proveedor esté permanentemente disponible. Esa independencia es una de las propiedades más valiosas de Git.
Otra cosa son los servicios que rodean al repositorio. Si aprobaciones, pruebas, artefactos y despliegues dependen de una plataforma, la copia local no permite continuar todo el proceso. El código está distribuido, pero el flujo de trabajo puede estar muy centralizado.
Surgen así dos requisitos: fiabilidad de la plataforma y adecuación del control de versiones al volumen y la forma de trabajar. Cambiar de alojamiento no resuelve automáticamente todos los problemas de escala. Una mala etapa de la plataforma tampoco justifica sustituir Git por completo.
Anthropic construye Scion para una escala excepcional
Anthropic habla de unas 2.500 modificaciones fusionadas al día en mayo de 2026, frente a más de 30.000 en septiembre. El historial de la rama principal se acercaría a los 100 GB y la copia de trabajo comprimida superaría los 25 GB. Solo la integración continua realizaría unos 25 millones de checkouts diarios. Los más de 600 PB diarios citados son una extrapolación de descargas completas ingenuas, no tráfico diario realmente medido.
Su respuesta es Scion. Anthropic describe una migración en cinco meses junto con la herramienta de revisión Antique y otra infraestructura interna. Scion presupone clientes conectados y traslada las operaciones de versiones al servidor. Carga archivos bajo demanda y responde muchas consultas mediante API. Así, una tarea no necesita una copia local del repositorio para cada pregunta.
La limitación que señala Anthropic es esencial: Scion no es un sustituto general de Git ni un GitHub público anunciado para todos. Está diseñado para monorepositorios enormes y su propia carga de agentes. Anthropic también quiere compartir aprendizajes con el ecosistema Git. «Anthropic construye el próximo GitHub» describe, como mucho, un cambio técnico, no un producto competidor ya disponible.
Por qué un cliente pequeño puede marcar una gran diferencia
La idea se entiende sin operar a esa escala. Imaginemos una tarea automática que comprueba si cambió un archivo de configuración entre dos versiones. Necesita responder una pregunta concreta. Preparar un entorno local amplio puede exigir más recursos que la comprobación misma.
Con una sola tarea quizá apenas se note. En muchas instancias de corta duración, la preparación, las transferencias y la limpieza repetidas pueden consumir una parte importante de los recursos. Un servicio que entrega exactamente los datos necesarios cambia esa cuenta. Es una decisión arquitectónica, no la prueba de que cada pequeño repositorio necesite un servidor central de versiones.
El precio es depender más de la disponibilidad de ese servicio. Trasladar trabajo al servidor obliga a tomarse en serio sus fallos, permisos, recuperación y capacidad. Tener menos datos locales resulta cómodo hasta que el servicio remoto deja de responder.
Me gusta que se cuestione una suposición habitual. No lo convertiría en una recomendación universal. En un proyecto pequeño, el historial Git completo en local puede ofrecer el equilibrio adecuado de sencillez, rapidez e independencia.
Cloudflare conserva Git y hace programables los repositorios
Cloudflare toma otra dirección con Artifacts. Presentado en abril, ofrece almacenamiento versionado con interfaz compatible con Git. Sus API permiten crear, importar y bifurcar repositorios, y los clientes Git normales pueden utilizarlos. Cloudflare plantea repositorios separados para proyectos, tareas o sesiones de agentes, guardando código y contexto versionados. La base se aprovisiona mediante programación en vez de configurar manualmente cada repositorio como espacio permanente.
La compatibilidad con Git tiene valor estratégico. Las herramientas existentes y los procesos conocidos facilitan empezar. Un producto nuevo puede centrarse en la colaboración sin introducir simultáneamente un protocolo de versiones completamente distinto.
En octubre, Cloudflare anunció la beta abierta para clientes con un plan Workers de pago. Las nuevas integraciones conectan Artifacts con Workers Builds y entornos de previsualización. Los eventos pueden iniciar revisiones automáticas y los tokens por repositorio limitan el acceso. Cloudflare invita expresamente a otros a construir la próxima plataforma Git sobre Workers y Artifacts. Es infraestructura con ambición de plataforma, todavía no un GitHub completo con un ecosistema social y organizativo equivalente.
La diferencia interesante es dónde pone cada empresa el límite. Anthropic optimiza su propio sistema de desarrollo gigantesco. Cloudflare ofrece una base para productos ajenos. La interfaz de personas, agentes y decisiones compartidas sigue siendo un problema de producto aparte.
Por qué estas empresas quieren estar ahí
El motivo directamente documentado de Anthropic es su propio cuello de botella. Que investigación y desarrollo esperen al control de versiones cuesta tiempo y capacidad de cómputo. Mejorar su infraestructura interna aporta valor aunque Scion nunca llegue al público.
Además, veo interés estratégico en hacer útiles los agentes durante procesos largos. Un modelo que escribe una función tiene valor. Un agente que entiende el proyecto, prepara cambios revisables y encaja en la infraestructura puede integrarse mucho más en el trabajo diario. Es mi interpretación económica, no un plan comercial de Scion confirmado por Anthropic.
En Cloudflare, la conexión con el negocio de infraestructura es más directa. Ejecutar aplicaciones en Workers y guardar sus datos de desarrollo en Artifacts incorpora más trabajo a la misma plataforma. Artifacts factura operaciones y volumen almacenado, según Cloudflare. Más agentes pueden implicar más repositorios, accesos y cómputo. La rentabilidad de cada proceso depende de su uso real.
La integración también crea dependencia. Mover un repositorio Git suele ser relativamente sencillo. Trasladar un sistema de API específicas, procesos de agentes, eventos, permisos, previsualizaciones y despliegues resulta más difícil. Cuanto mejor encaja todo, mayor es el esfuerzo práctico para cambiar de proveedor.
Estos incentivos no contradicen el beneficio técnico. Un servicio puede resolver un problema real y reforzar a su proveedor. Precisamente por eso quiero mirar ambos lados antes de convertir una integración cómoda en una dependencia que nadie cuestiona.
El código contiene más que instrucciones
Y sí, los datos de entrenamiento pertenecen a esta discusión. Merecen atención como posible interés estratégico. Usarlos para explicar cualquier nueva plataforma Git sería demasiado fácil.
Un repositorio contiene más que la solución actual. Su historial puede mostrar qué se intentó primero, qué prueba falló, por qué una revisión rechazó un cambio y qué corrección se aceptó. Esa relación puede ser especialmente valiosa para desarrollar sistemas de programación: tarea, intento, respuesta y resultado verificable quedan conectados.
Pensemos en un ejemplo ficticio. Un agente debe corregir un cálculo de fechas. Su primera propuesta supera las pruebas existentes, pero falla una nueva prueba de cambio de año. Un revisor explica la suposición equivocada y la siguiente modificación la corrige. El valor de aprendizaje estaría tanto en el código final como en el camino del error plausible a la solución razonada. Si un proveedor utiliza esos datos y tiene permiso para hacerlo es otra cuestión.
El valor del código no desaparece porque generarlo sea más barato. Requisitos fiables, decisiones documentadas, buenas pruebas, experiencia de mantenimiento e interoperabilidad demostrada siguen costando trabajo. Una montaña de archivos generados no los sustituye. Cuando pueden producirse infinitas propuestas, las pruebas de que una resuelve realmente el problema ganan valor.
Esta es mi valoración del potencial económico y técnico. Los anuncios aquí comentados no demuestran que Anthropic recopile repositorios privados ajenos mediante Scion ni que Cloudflare use Artifacts para entrenar su propio modelo de programación.
Qué hay que distinguir realmente en el entrenamiento
El interés de la IA por los datos de desarrollo no es puramente hipotético. En marzo de 2026, GitHub anunció que desde el 24 de abril utilizaría interacciones de ciertos planes personales de Copilot para entrenamiento salvo oposición del usuario. Distingue expresamente las interacciones activas del contenido almacenado en repositorios privados, que no leería indiscriminadamente para este fin. Copilot Business y Enterprise tienen otras protecciones. GitHub Copilot
Anthropic afirma que, por defecto, no entrena con entradas y salidas de sus productos comerciales. Los comentarios enviados voluntariamente y la participación expresa en programas pueden recibir un tratamiento distinto. No es una promesa general para cualquier plan personal o configuración. Anthropic
Ante un servicio nuevo querría saber qué contenido solo se almacena, cuál se procesa para responder y cuál se usa para mejorar el producto o entrenar. Son actividades diferentes. Trabajar con código exige procesarlo, pero no concede automáticamente permiso para incorporarlo permanentemente a un modelo.
Llamarlo código abierto tampoco resuelve todas las preguntas de uso. Hay que distinguir visibilidad pública, licencia, material confidencial y condiciones del servicio. Una política de datos comprensible forma parte del producto tanto como una API útil.
El próximo GitHub debe facilitar mejores decisiones
La visión más cómoda sería una plataforma donde innumerables agentes generan código sin límite y otros agentes lo aprueban todo. No me convence. Si varios sistemas comparten una suposición incorrecta, su acuerdo no constituye una verificación independiente.
Una plataforma útil debería mostrar qué encargo resuelve cada cambio, desde qué versión parte, qué pruebas se ejecutaron y quién responde por su aceptación. Cambios paralelos pueden parecer correctos por separado y causar daños juntos. Fusionarlos más rápido no elimina el problema.
El contexto de los agentes también necesita límites. Descripciones, registros y archivos de configuración pueden contener información que no debe llegar a cualquier repositorio o entorno externo. Guardar sesiones crea otro conjunto de datos además de una ayuda para desarrollar. Sus accesos y su duración merecen decisiones conscientes.
En código abierto sigue importando la parte humana: confiar en quienes mantienen el proyecto, comprender las discusiones y cuidarlo durante años. Un alojamiento más rápido puede apoyar ese trabajo. Más actividad automatizada, por sí sola, no puede sustituirlo.
GitHub tiene competencia, pero la sucesión está abierta
Me parece sano volver a cuestionar incluso las herramientas fundamentales. Si la IA permite a más personas crear software, podemos preguntar si las plataformas actuales siguen encajando con ese trabajo.
Anthropic muestra una reconstrucción interna especializada. Cloudflare abre infraestructura para nuevos productos. GitHub conserva un ecosistema que una alternativa tendría que sustituir o complementar útilmente. Una arquitectura de almacenamiento nueva no decidirá sola esa competencia.
Para mí importa quién logrará que más personas y agentes colaboren productivamente sin perder trazabilidad, independencia ni control de sus datos. Ese es el criterio para el próximo GitHub. Y probablemente ahí también se encuentre una parte considerable del negocio.
Hasta la próxima,
Joe