Quem constrói o próximo GitHub? Código, IA e poder
Ai SecurityÍndice
O GitHub é uma plataforma para guardar, desenvolver e publicar software em conjunto. Na sua base está o Git, uma ferramenta de controlo de versões: regista alterações nos ficheiros, permite ramos de desenvolvimento paralelos e ajuda a reunir diferentes versões do trabalho. O Git fornece a base técnica. O GitHub acrescenta colaboração através de problemas reportados, discussões, pedidos de integração e processos automatizados.
O Git nasceu em 2005 no desenvolvimento do kernel Linux. O GitHub foi fundado em 2008 e abriu ao público a 10 de abril de 2008. Dez anos depois, a Microsoft comprou a empresa por 7,5 mil milhões de dólares, anunciando a conclusão a 26 de outubro de 2018. Uma casa para programadores tornou-se infraestrutura central do software. Git, GitHub, Microsoft
Em 2026, parece de repente que uma em cada duas pessoas fora do desenvolvimento tradicional também tem conta no GitHub. Uma pequena aplicação, um painel pessoal, uma ferramenta de IA que pede uma ligação a um repositório. É a minha impressão deliberadamente exagerada, não uma estatística sobre não programadores. A mudança de fundo importa: criar software é mais acessível, enquanto a infraestrutura suporta novas cargas.
Por isso me interessa quem construirá o próximo GitHub. A Anthropic reconstruiu o seu controlo de versões interno. A Cloudflare oferece componentes para novas plataformas Git. Entretanto, a fiabilidade do GitHub é questionada publicamente. Está em causa muito mais do que um botão de integração melhor: quem controla o lugar onde o software é criado, revisto e levado à produção?
Quando os utilizadores se tornam criadores de software
A mudança começou antes deste ano. No Octoverse 2025, o GitHub já contava mais de 180 milhões de programadores e mais de 36 milhões de novos utilizadores num ano. Segundo o GitHub, quase 80% dos novos programadores usavam o Copilot na primeira semana. São dados do fornecedor, não uma prova de que a IA causou todo o crescimento. Mostram, porém, como a entrada no GitHub está ligada às ferramentas de IA.
Antes, construir uma pequena ferramenta exigia aprender programação suficiente para chegar a um início útil. Hoje é possível descrever uma ideia e concretizá-la gradualmente com um agente de programação. O conhecimento continua necessário, sobretudo com dados, permissões e sistemas em produção. Ainda assim, a distância entre uma ideia e um primeiro programa funcional diminuiu bastante.
Vejo enorme potencial para o código aberto: documentação mais clara, novos testes, investigação de erros, interfaces mais acessíveis e ideias abandonadas retomadas. São formas concretas de acelerar o desenvolvimento. Não demonstram uma melhoria da qualidade de todos os projetos. Um repositório adicional não é software mantido, e outro pedido de integração pode dar mais trabalho a quem o mantém.
Interessa-me menos quantas linhas um agente produz do que quantas podem ser compreendidas, verificadas e mantidas. Quando o código chega mais depressa, o estrangulamento passa para as pessoas e os sistemas que decidem o que merece ficar.
A árvore de Natal na página de estado
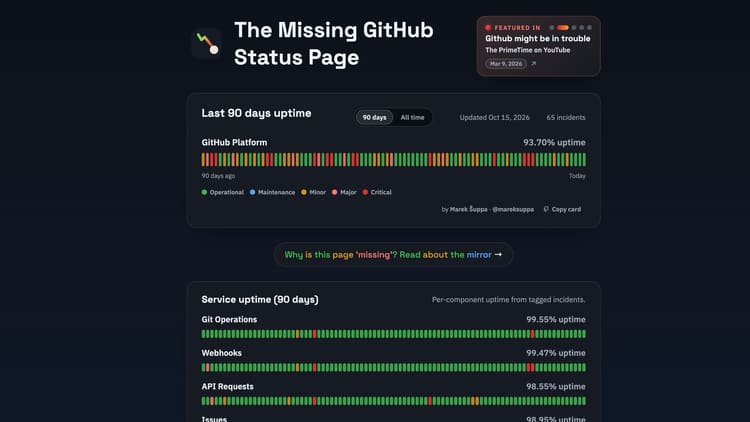
A imagem de cabeçalho mostra The Missing GitHub Status Page, de Marek Šuppa. A captura de 15 de outubro de 2026 apresenta 65 incidentes e 93,70% de disponibilidade da plataforma em 90 dias. Para Git Operations, apresenta 99,55%. Estes valores pertencem àquela captura, não são medições atuais feitas por mim.
A página não oficial reconstrói intervalos a partir de relatórios públicos e combina interrupções sobrepostas. O valor global agrega serviços diferentes. Não significa que clones Git, pedidos de integração e Actions tenham falhado simultaneamente para todos em cada incidente. Assim, 93,70% não equivale simplesmente a «GitHub completamente desligado durante 6,30% do tempo». A interpretação depende da agregação e dos incidentes incluídos.
Mesmo assim, a imagem toca num ponto sensível. Uma plataforma de versões faz parte da cadeia de produção. Uma revisão inacessível, uma compilação bloqueada ou uma API avariada podem atrasar uma publicação mesmo com todo o código disponível localmente. Para o processo afetado, interessa que funcione toda a cadeia.
O gráfico também não prova que a IA causou estes incidentes. Ajuda a compreender o interesse em alternativas. As causas de cada falha devem ser avaliadas no respetivo relatório.
Porque é preciso distinguir Git de GitHub
Uma falha do GitHub não revela automaticamente um problema no modelo de dados do Git. Com uma cópia local completa, posso registar alterações, comparar versões e trabalhar em ramos sem um fornecedor permanentemente acessível. Esta independência é uma das qualidades do Git que mais valorizo.
Os serviços à volta do repositório são outra questão. Se aprovações, testes, artefactos e disponibilização dependem da plataforma, a cópia local não permite continuar todo o processo. O código está distribuído, mas o trabalho pode estar fortemente centralizado.
Há, por isso, duas necessidades: fiabilidade da plataforma e adequação do controlo de versões ao volume e à forma de trabalhar. Mudar de alojamento não resolve automaticamente todos os problemas de escala. Uma fase difícil da plataforma também não justifica substituir totalmente o Git.
A Anthropic constrói o Scion para uma escala invulgar
A Anthropic refere cerca de 2.500 alterações integradas por dia em maio de 2026, passando para mais de 30.000 em setembro. O histórico do ramo principal aproximar-se-ia dos 100 GB e a cópia de trabalho comprimida ultrapassaria 25 GB. Só a CI executaria cerca de 25 milhões de checkouts diários. Os mais de 600 PB de transferências por dia citados são uma extrapolação de descargas completas ingénuas, não tráfego realmente medido.
A resposta chama-se Scion. A Anthropic descreve uma migração em cinco meses, juntamente com a ferramenta de revisão Antique e outra infraestrutura interna. O Scion pressupõe clientes ligados e transfere operações de versões para o servidor. Os ficheiros são carregados conforme necessário e muitas consultas respondidas por API. Uma tarefa deixa assim de precisar de uma cópia local do repositório para cada pergunta.
O limite indicado pela própria Anthropic é essencial: o Scion não é um substituto geral do Git nem um GitHub público anunciado para todos. Destina-se a monorrepositórios enormes e à carga dos seus agentes. A empresa também quer partilhar aprendizagens com o ecossistema Git. «A Anthropic constrói o próximo GitHub» descreve, no máximo, uma mudança técnica, não um concorrente já disponível.
Porque um cliente pequeno pode fazer uma grande diferença
A ideia entende-se sem operar àquela escala. Imaginemos uma tarefa automática que verifica se um ficheiro de configuração mudou entre duas versões. Precisa de uma resposta específica. Preparar um grande ambiente local pode consumir mais recursos do que a própria verificação.
Numa única tarefa, talvez pouco se note. Em muitos ambientes temporários, preparação, transferências e limpeza repetidas podem consumir uma parte significativa dos recursos. Um serviço que entrega exatamente os dados necessários altera a conta. É uma escolha arquitetural, não a prova de que cada pequeno repositório precisa de um servidor central.
O preço é depender mais da disponibilidade do serviço. Transferir trabalho para o servidor exige atenção às falhas, permissões, recuperação e capacidade. Menos dados locais são convenientes até o serviço remoto deixar de responder.
Gosto de ver uma suposição habitual questionada. Não a transformaria numa recomendação universal. Num projeto pequeno, o histórico Git completo em local pode oferecer o equilíbrio certo de simplicidade, rapidez e independência.
A Cloudflare mantém o Git e torna os repositórios programáveis
A Cloudflare segue outra via com o Artifacts. Apresentado em abril, oferece armazenamento versionado com interface compatível com Git. As API permitem criar, importar e bifurcar repositórios; os clientes Git normais podem utilizá-los. A Cloudflare aponta repositórios separados por projeto, tarefa ou sessão de agente, guardando código e contexto versionados. A base pode ser criada programaticamente em vez de configurar manualmente cada repositório como espaço permanente.
A compatibilidade com Git tem valor estratégico. Ferramentas existentes e processos conhecidos facilitam a adoção. Um produto novo pode concentrar-se na colaboração sem introduzir simultaneamente um protocolo de versões completamente diferente.
Em outubro, a Cloudflare anunciou a beta aberta para clientes com um plano Workers pago. Integrações recentes ligam o Artifacts ao Workers Builds e a ambientes de pré-visualização. Eventos podem iniciar revisões automáticas e tokens específicos limitam o acesso a cada repositório. A Cloudflare convida expressamente outros a construir a próxima plataforma Git sobre Workers e Artifacts. É infraestrutura com ambição de plataforma, ainda não um GitHub completo com ecossistema social e organizacional equivalente.
A diferença interessante é a fronteira escolhida. A Anthropic otimiza o seu enorme sistema interno. A Cloudflare fornece uma base para produtos de terceiros. A interface entre pessoas, agentes e decisões partilhadas continua a ser um problema de produto separado.
Porque estas empresas querem estar aí
A razão diretamente documentada pela Anthropic é o seu próprio estrangulamento. Investigação e desenvolvimento à espera de operações de versões custam tempo e capacidade computacional. Melhor infraestrutura interna tem valor mesmo que o Scion nunca chegue ao público.
Vejo também interesse estratégico em tornar agentes úteis ao longo de processos extensos. Um modelo que escreve uma função tem valor. Um agente que compreende um projeto, prepara alterações verificáveis e funciona com a infraestrutura pode integrar-se muito mais no quotidiano. É a minha interpretação económica, não um plano comercial do Scion confirmado pela Anthropic.
Na Cloudflare, a ligação ao negócio de infraestrutura é mais direta. Executar aplicações no Workers e guardar dados de desenvolvimento no Artifacts coloca mais trabalho na mesma plataforma. A Cloudflare indica faturação por operações e dados armazenados. Mais agentes podem significar mais repositórios, acessos e computação. A viabilidade económica depende da utilização concreta.
A integração cria igualmente dependência. Mover um repositório Git costuma ser relativamente simples. Transferir API específicas, processos de agentes, eventos, permissões, pré-visualizações e disponibilizações é mais difícil. Quanto mais comodamente tudo funciona em conjunto, maior o esforço para mudar de fornecedor.
Estes incentivos não contradizem as vantagens técnicas. Um serviço pode resolver um problema real e reforçar o fornecedor. Precisamente por isso quero considerar ambos os lados antes que uma integração agradável se torne uma dependência que ninguém questiona.
O código contém mais do que texto de programa
E sim, os dados de treino pertencem a esta discussão. Merecem atenção como possível interesse estratégico. Usá-los como explicação para qualquer nova plataforma Git seria demasiado fácil.
Um repositório contém muitas vezes mais do que a solução atual. O histórico pode mostrar a primeira tentativa, o teste que falhou, a razão de uma rejeição e a correção finalmente aceite. Essa relação pode ser valiosa para desenvolver sistemas de programação: tarefa, tentativa, resposta e resultado verificável estão ligados.
Um exemplo inventado ajuda. Um agente corrige um cálculo de datas. A primeira proposta passa os testes existentes, mas falha um novo teste de mudança de ano. Um revisor explica a suposição errada e a alteração seguinte corrige-a. O valor de aprendizagem estaria no código final e no caminho do erro plausível à solução fundamentada. Se um fornecedor utiliza esses dados e tem autorização para tal é uma questão distinta.
O valor do código não desaparece por a geração ficar mais barata. Requisitos fiáveis, decisões documentadas, bons testes, experiência de manutenção e funcionamento demonstrado continuam a exigir trabalho. Uma montanha de ficheiros gerados não os substitui. Quando as propostas podem ser ilimitadas, a prova de que uma resolve realmente o problema ganha valor.
Esta é a minha avaliação do potencial económico e técnico. Os anúncios discutidos não demonstram que a Anthropic recolha repositórios privados alheios pelo Scion nem que a Cloudflare use o Artifacts para treinar um modelo próprio de programação.
O que distinguir realmente no treino
O interesse da IA por dados de desenvolvimento não é puramente teórico. Em março de 2026, o GitHub anunciou que, a partir de 24 de abril, usaria interações de determinados planos pessoais Copilot para treino, salvo oposição. Distingue explicitamente interações ativas dos conteúdos privados armazenados em repouso, que não seriam lidos indiscriminadamente para esse fim. Copilot Business e Enterprise têm outras proteções. GitHub Copilot
A Anthropic afirma não usar por predefinição entradas e saídas dos seus produtos comerciais no treino. Feedback voluntário e participação expressa em programas podem ser tratados de outra forma. Não é uma garantia geral para todos os planos pessoais e definições. Anthropic
Num novo serviço, gostaria de saber que conteúdos são apenas guardados, quais são processados para responder e quais são usados para melhorar o produto ou treinar. São atividades diferentes. Processar código para trabalhar nele não concede automaticamente autorização para o incorporar de forma permanente num modelo.
A designação código aberto também não resolve todas as questões de utilização. Visibilidade pública, licença, elementos confidenciais e condições do serviço precisam de ser separados. Uma política de dados compreensível faz parte do produto tanto como uma API útil.
O próximo GitHub deve permitir melhores decisões
A visão mais cómoda seria uma plataforma onde agentes ilimitados geram código sem fim e outros aprovam tudo automaticamente. Não me convence. Vários sistemas que partilham uma suposição errada não produzem uma prova independente só por concordarem.
Uma plataforma útil deve mostrar a tarefa cumprida por cada alteração, a versão de partida, os controlos executados e quem responde pela aceitação. Alterações paralelas podem parecer corretas isoladamente e estragar algo em conjunto. Integrações mais rápidas não eliminam isso.
O contexto dos agentes também exige limites. Descrições, registos e configurações podem conter informação inadequada para qualquer repositório ou ambiente externo. Guardar sessões cria um novo conjunto de dados além da ajuda ao desenvolvimento. Acesso e duração merecem uma definição consciente.
No código aberto, a parte humana continua essencial: confiança nos responsáveis, discussões compreensíveis e vontade de cuidar de um projeto durante anos. Alojamento mais rápido pode apoiar esse trabalho. Mais atividade automática, só por si, não o substitui.
O GitHub é desafiado, mas a sucessão continua aberta
Considero saudável questionar novamente até as ferramentas fundamentais. Se a IA permite a mais pessoas criar software, podemos perguntar se as plataformas existentes ainda se adequam ao trabalho resultante.
A Anthropic mostra uma reconstrução interna especializada. A Cloudflare abre infraestrutura para novos produtos. O GitHub mantém um ecossistema que uma alternativa terá de substituir ou complementar de forma útil. Uma arquitetura de armazenamento nova não decidirá sozinha esta competição.
Para mim, importa quem conseguirá pôr mais pessoas e agentes a colaborar produtivamente sem perder rastreabilidade, independência e controlo dos dados. Esse é o critério para o próximo GitHub. E provavelmente é também onde reside uma parte substancial do negócio.
Até à próxima,
Joe