Qui construit le prochain GitHub ? Code, IA et pouvoir
Ai SecurityTable des matières
GitHub est une plateforme permettant de stocker, développer et publier des logiciels ensemble. Elle repose sur Git, un outil de gestion de versions : il conserve la trace des modifications, permet des branches de développement parallèles et aide à réunir différentes versions du travail. Git apporte le socle technique. GitHub y ajoute la collaboration, avec les signalements de problèmes, les discussions, les demandes de fusion et les processus automatisés.
Git est né en 2005 du développement du noyau Linux. GitHub a été fondé en 2008 et ouvert au public le 10 avril 2008. Dix ans plus tard, Microsoft a racheté l’entreprise pour 7,5 milliards de dollars, annonçant la finalisation le 26 octobre 2018. Ce lieu destiné aux développeurs est devenu une infrastructure centrale du logiciel. Git, GitHub, Microsoft
En 2026, on a soudain l’impression qu’une personne sur deux en dehors du développement traditionnel possède aussi un compte GitHub. Une petite application ici, un tableau de bord personnel là, un outil d’IA qui demande de connecter un dépôt. C’est mon impression volontairement exagérée, pas une statistique sur les non-développeurs. Le changement sous-jacent reste important : créer un logiciel devient plus accessible, tandis que l’infrastructure doit absorber de nouvelles charges.
Voilà pourquoi je m’intéresse au prochain GitHub. Anthropic a reconstruit sa gestion de versions interne. Cloudflare propose des briques pour de nouvelles plateformes Git. Dans le même temps, la fiabilité de GitHub est publiquement remise en question. L’enjeu dépasse largement un meilleur bouton de fusion : qui contrôlera le lieu où les logiciels sont créés, examinés et acheminés vers la production ?
Quand les utilisateurs deviennent créateurs de logiciels
Le mouvement précède cette année. Le rapport Octoverse 2025 de GitHub comptait déjà plus de 180 millions de développeurs, dont plus de 36 millions de nouveaux utilisateurs en un an. Selon GitHub, près de 80 % des nouveaux développeurs utilisaient Copilot dès leur première semaine. Ce sont des chiffres du fournisseur, pas la preuve que l’IA explique toute la croissance. Ils montrent néanmoins combien l’arrivée sur GitHub est liée aux outils d’IA.
Auparavant, créer un petit outil demandait souvent d’apprendre assez de programmation pour obtenir un début utile. Aujourd’hui, on peut décrire une idée et la réaliser progressivement avec un agent de programmation. L’expertise reste nécessaire, surtout avec les données, les permissions et les systèmes en production. La distance entre une idée et un premier programme fonctionnel s’est pourtant nettement réduite.
J’y vois un potentiel énorme pour l’open source : clarifier la documentation, ajouter des tests, rechercher des défauts, rendre des interfaces accessibles et reprendre des idées abandonnées. Ce sont des moyens concrets d’accélérer le développement. Cela ne prouve pas que tous les projets gagnent en qualité. Un dépôt supplémentaire ne constitue pas un logiciel entretenu, et une demande de fusion peut aussi alourdir le travail du mainteneur.
Le nombre de lignes générées m’intéresse moins que la part pouvant être comprise, vérifiée et maintenue. Quand le code arrive plus vite, le goulet d’étranglement se déplace vers les personnes et les systèmes qui décident ce qui mérite de rester.
Le sapin de Noël de la page de statut
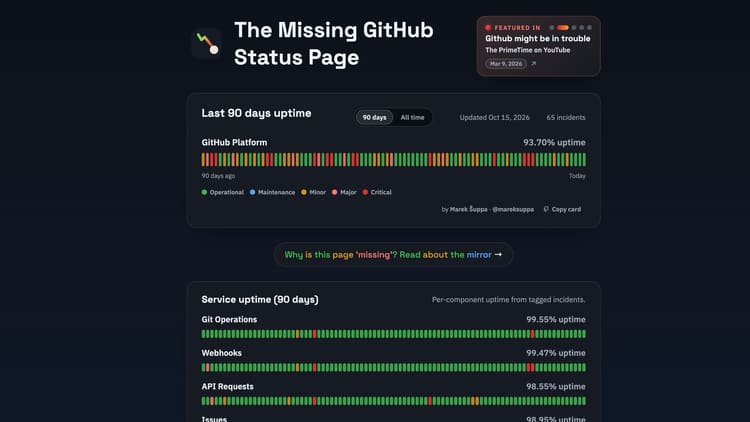
L’image d’en-tête montre The Missing GitHub Status Page, de Marek Šuppa. La capture du 15 octobre 2026 affiche 65 incidents et 93,70 % de disponibilité de la plateforme sur 90 jours. Git Operations affiche en revanche 99,55 %. Ces chiffres appartiennent à cette capture ; ce ne sont pas de nouvelles mesures que j’aurais réalisées.
Cette page non officielle reconstitue des intervalles à partir des rapports publics et fusionne les interruptions qui se chevauchent. Une valeur globale agrège plusieurs services. Elle ne signifie pas que les clonages Git, les demandes de fusion et Actions étaient simultanément indisponibles pour tous à chaque incident. Ainsi, 93,70 % ne signifie pas simplement « GitHub était entièrement hors ligne pendant 6,30 % du temps ». L’interprétation dépend de l’agrégation et des incidents retenus.
L’image touche néanmoins un point sensible. Une plateforme de versions fait désormais partie de la chaîne de production. Une revue inaccessible, une compilation bloquée ou une API perturbée peuvent retarder une publication alors que le code existe entièrement en local. Pour le processus concerné, c’est toute la chaîne qui doit fonctionner.
Le graphique ne démontre pas non plus que l’IA a causé ces incidents. Il aide à comprendre l’attention portée aux alternatives. Les causes de chaque panne doivent être évaluées à partir du rapport correspondant.
Pourquoi distinguer Git et GitHub
Une panne de GitHub ne démontre pas en elle-même un défaut du modèle de données Git. Avec une copie locale complète, je peux enregistrer des modifications, comparer des versions et travailler sur des branches sans fournisseur constamment joignable. Cette indépendance est pour moi une des qualités les plus précieuses de Git.
Les services construits autour du dépôt sont une autre affaire. Si validations, tests, artefacts et déploiements dépendent d’une plateforme, la copie locale ne permet pas de poursuivre tout le processus. Le code est distribué, mais le travail peut être fortement centralisé.
Deux besoins se distinguent : la fiabilité de la plateforme et l’adéquation de la gestion de versions au volume de données et au fonctionnement des utilisateurs. Changer d’hébergeur ne résout pas automatiquement tous les problèmes d’échelle. Une mauvaise période de la plateforme ne justifie pas davantage de remplacer Git intégralement.
Anthropic construit Scion pour une échelle inhabituelle
Anthropic évoque environ 2 500 modifications fusionnées par jour en mai 2026, puis plus de 30 000 en septembre. L’historique de la branche principale approcherait 100 Go et la copie de travail compressée dépasserait 25 Go. L’intégration continue effectuerait à elle seule environ 25 millions de checkouts quotidiens. Les plus de 600 Po de transferts quotidiens cités sont une extrapolation de récupérations complètes naïves, pas un trafic réellement mesuré.
Sa réponse s’appelle Scion. Anthropic décrit une migration en cinq mois, accompagnée de l’outil de revue Antique et d’autres composants internes. Scion suppose des clients connectés et déplace les opérations de versions sur le serveur. Les fichiers sont chargés à la demande ; des API répondent directement à de nombreuses requêtes. Une tâche n’a donc pas besoin d’une copie locale du dépôt pour chaque question.
La limite soulignée par Anthropic est essentielle : Scion n’est ni un remplacement universel de Git ni un GitHub public annoncé pour tous. Il vise des monodépôts immenses et la charge de ses propres agents. Anthropic souhaite aussi partager ses enseignements avec l’écosystème Git. « Anthropic construit le prochain GitHub » décrit au mieux une réorientation technique, pas un concurrent déjà disponible.
Pourquoi un petit client peut changer beaucoup de choses
L’idée se comprend sans opérer à cette échelle. Imaginons une tâche automatisée vérifiant si un fichier de configuration a changé entre deux versions. Elle cherche une réponse précise. Préparer un vaste environnement local peut coûter davantage que la vérification elle-même.
Pour une seule tâche, cette surcharge paraît négligeable. Avec beaucoup d’environnements éphémères, installations, transferts et nettoyages répétés peuvent consommer une grande partie des ressources. Un service livrant exactement les données nécessaires change le calcul. C’est un arbitrage architectural, pas la preuve que chaque petit dépôt nécessite un serveur central de versions.
La contrepartie est une dépendance accrue à la disponibilité du service. Plus on déplace de travail vers un serveur, plus ses pannes, autorisations, capacités de restauration et limites comptent. Avoir moins de données en local est pratique jusqu’à ce que le service distant ne réponde plus.
J’apprécie cette remise en cause d’une habitude. Je n’en ferais pourtant pas une recommandation universelle. Pour un projet modeste, l’historique Git complet en local peut offrir le bon équilibre entre simplicité, vitesse et indépendance.
Cloudflare conserve Git et rend les dépôts programmables
Cloudflare prend une autre voie avec Artifacts. Présenté en avril, le service propose un stockage versionné doté d’une interface compatible Git. Des API créent, importent et bifurquent les dépôts ; les clients Git ordinaires restent utilisables. Cloudflare évoque des dépôts séparés pour chaque projet, tâche ou session d’agent, conservant code et contexte versionnés. Le socle est provisionné par programme plutôt que configuré manuellement comme un poste de travail permanent.
Cette compatibilité possède un intérêt stratégique. Outils existants et habitudes facilitent l’adoption. Un nouveau produit peut d’abord se concentrer sur la collaboration sans introduire simultanément un protocole de versions entièrement inédit.
En octobre, Cloudflare a annoncé la bêta ouverte pour les clients disposant d’un forfait Workers payant. Les intégrations récentes relient Artifacts à Workers Builds et aux environnements de prévisualisation. Les événements peuvent déclencher des revues automatiques, et les jetons propres à chaque dépôt limitent l’accès. Cloudflare invite expressément d’autres acteurs à construire la prochaine plateforme Git sur Workers et Artifacts. C’est une infrastructure ambitieuse, pas encore un GitHub complet avec un écosystème social et organisationnel équivalent.
La différence intéressante est la frontière choisie. Anthropic optimise son immense système de développement. Cloudflare fournit une base aux produits des autres. L’interface entre humains, agents et décisions collectives reste un problème de produit distinct.
Pourquoi ces entreprises veulent occuper cette place
Le motif directement documenté chez Anthropic est son propre goulet d’étranglement. Faire attendre recherche et développement sur des opérations de versions coûte du temps et des ressources. Une meilleure infrastructure interne a une valeur même si Scion ne devient jamais public.
J’y vois aussi un intérêt stratégique à rendre les agents utiles sur des processus plus longs. Un modèle qui écrit une fonction a de la valeur. Un agent qui comprend le projet, prépare des modifications vérifiables et s’intègre à l’infrastructure peut s’ancrer bien davantage dans le quotidien. C’est mon analyse économique, pas un plan de commercialisation de Scion confirmé par Anthropic.
Chez Cloudflare, le lien avec l’activité d’infrastructure est plus direct. Exécuter des applications sur Workers et conserver leurs données de développement dans Artifacts place davantage de travail sur la même plateforme. Cloudflare indique une facturation selon les opérations et le volume stocké. Plus d’agents peuvent impliquer plus de dépôts, d’accès et de calcul. La rentabilité d’un processus dépend de son usage réel.
L’intégration crée également de l’attachement. Un dépôt Git est souvent assez simple à déplacer. Un ensemble d’API spécifiques, de processus d’agents, d’événements, de permissions, de prévisualisations et de déploiements l’est beaucoup moins. Plus tout fonctionne commodément ensemble, plus changer de fournisseur demande d’efforts.
Ces intérêts ne contredisent pas les bénéfices techniques. Un service peut résoudre un vrai problème et renforcer son fournisseur. C’est précisément pourquoi je veux examiner les deux aspects avant qu’une intégration agréable devienne une dépendance que personne ne questionne.
Le code contient davantage que du texte exécutable
Et oui, les données d’entraînement font partie de cette discussion. Elles méritent attention comme intérêt stratégique possible. En faire l’explication de toute nouvelle plateforme Git serait trop facile.
Un dépôt contient souvent davantage que la solution actuelle. L’historique peut révéler le premier essai, le test ayant échoué, la raison du rejet d’une modification et la correction finalement acceptée. Ce lien est potentiellement très précieux pour les systèmes de programmation : tâche, tentative, retour et résultat vérifiable sont reliés.
Prenons un exemple fictif. Un agent corrige un calcul de dates. Sa première proposition passe les tests existants, mais échoue à un nouveau test de changement d’année. Un relecteur explique l’hypothèse erronée ; la modification suivante la corrige. L’apprentissage porterait autant sur le code final que sur le chemin allant d’une erreur plausible à une solution justifiée. L’utilisation réelle de ces données par un fournisseur et son droit de le faire restent des questions distinctes.
La valeur du code ne disparaît donc pas simplement quand sa génération devient moins chère. Exigences fiables, décisions documentées, bons tests, expérience de maintenance et fonctionnement démontré restent coûteux. Une montagne de fichiers générés ne les remplace pas. Quand les propositions deviennent innombrables, les preuves qu’une solution répond réellement au besoin gagnent en valeur.
C’est mon évaluation du potentiel économique et technique. Les annonces examinées ne prouvent ni qu’Anthropic collecte des dépôts privés tiers via Scion ni que Cloudflare exploite Artifacts pour entraîner son propre modèle de programmation.
Ce qu’il faut distinguer dans l’entraînement
L’intérêt de l’IA pour les données de développement n’est pas purement théorique. En mars 2026, GitHub a annoncé qu’à partir du 24 avril, les interactions de certains forfaits Copilot personnels serviraient à l’entraînement sauf opposition. GitHub distingue explicitement les interactions actives des contenus privés stockés au repos, qui ne seraient pas lus globalement à cette fin. D’autres protections concernent Copilot Business et Enterprise. GitHub Copilot
Anthropic indique de son côté ne pas utiliser par défaut les entrées et sorties de ses produits commerciaux pour l’entraînement. Les retours volontaires et la participation explicite à certains programmes peuvent être traités autrement. Ce n’est pas une promesse générale couvrant tous les forfaits personnels et réglages. Anthropic
Pour un nouveau service, je voudrais donc savoir quels contenus sont seulement stockés, lesquels sont traités pour répondre à une demande et lesquels servent à améliorer le produit ou à entraîner un modèle. Ce sont des opérations différentes. Un agent doit traiter le code pour travailler dessus ; cela ne lui donne pas automatiquement le droit de l’intégrer durablement à un modèle.
L’étiquette open source ne règle pas non plus toutes les questions d’usage. Code visible publiquement, licence, éléments confidentiels et conditions du service doivent être distingués. Une politique de données compréhensible fait autant partie du produit qu’une API utile.
Le prochain GitHub doit permettre de meilleures décisions
La vision la plus confortable serait une plateforme où des agents innombrables produisent du code sans limite et où d’autres approuvent tout automatiquement. Je n’y crois pas. Plusieurs systèmes partageant la même hypothèse fausse ne produisent pas une preuve indépendante en se donnant raison.
Une plateforme utile devrait montrer quelle tâche une modification remplit, sur quelle version elle repose, quels contrôles ont été exécutés et qui assume son acceptation. Des changements parallèles peuvent sembler corrects séparément et casser quelque chose ensemble. Fusionner plus vite n’élimine pas ce problème.
Le contexte des agents demande lui aussi des limites. Descriptions, journaux et fichiers de configuration peuvent contenir des informations qui n’ont pas leur place dans tous les dépôts ou environnements externes. Conserver les sessions crée une nouvelle collection de données en plus de l’aide au développement. Accès et durée de conservation méritent une conception volontaire.
Pour l’open source, l’humain reste essentiel : confiance dans les mainteneurs, échanges compréhensibles et volonté de s’occuper du projet pendant des années. Un hébergement plus rapide peut soutenir cela. Une activité automatisée plus abondante ne suffit pas à le remplacer.
GitHub est contesté, mais sa succession reste ouverte
Je trouve sain de remettre en question même les outils fondamentaux. Si l’IA permet à davantage de personnes de créer leurs logiciels, nous pouvons demander si les plateformes actuelles conviennent encore au travail qui en découle.
Anthropic montre une reconstruction interne spécialisée. Cloudflare ouvre une infrastructure à de nouveaux produits. GitHub conserve un écosystème qu’une alternative devrait remplacer ou compléter utilement. Une nouvelle architecture de stockage ne décidera pas seule de ce concours.
Pour moi, la question est de savoir qui fera collaborer davantage de personnes et d’agents sans perdre traçabilité, indépendance et maîtrise des données. Voilà le critère du prochain GitHub. C’est probablement aussi là qu’une bonne partie du marché se joue.
À la prochaine,
Joe