Chi costruisce il prossimo GitHub? Codice, IA e potere
Ai SecurityIndice dei contenuti
GitHub è una piattaforma per conservare, sviluppare e pubblicare software insieme. Alla base c’è Git, uno strumento di controllo delle versioni: registra le modifiche ai file, permette rami di sviluppo paralleli e aiuta a riunire versioni diverse del lavoro. Git costituisce il fondamento tecnico. GitHub aggiunge collaborazione attraverso segnalazioni, discussioni, pull request e processi automatizzati.
Git nacque nel 2005 dallo sviluppo del kernel Linux. GitHub fu fondata nel 2008 e aprì al pubblico il 10 aprile 2008. Dieci anni dopo Microsoft acquistò l’azienda per 7,5 miliardi di dollari, annunciando il completamento il 26 ottobre 2018. Da casa degli sviluppatori divenne un’infrastruttura centrale del software. Git, GitHub, Microsoft
Nel 2026 sembra improvvisamente che anche una persona su due fuori dallo sviluppo tradizionale abbia un account GitHub. Una piccola app, un cruscotto personale, uno strumento di IA che chiede di collegare un repository. È una mia impressione volutamente esagerata, non una statistica sui non sviluppatori. Il cambiamento sottostante conta comunque: creare software diventa più accessibile, mentre l’infrastruttura deve sostenere nuovi carichi.
Per questo mi interessa chi costruirà il prossimo GitHub. Anthropic ha riprogettato il controllo delle versioni interno. Cloudflare offre componenti per nuove piattaforme Git. Intanto l’affidabilità di GitHub viene discussa pubblicamente. La posta in gioco va oltre un pulsante di merge migliore: chi controllerà il luogo dove il software nasce, viene verificato e passa in produzione?
Quando gli utenti diventano creatori di software
Il cambiamento precede quest’anno. Nel rapporto Octoverse 2025 GitHub contava già oltre 180 milioni di sviluppatori e più di 36 milioni di nuovi utenti in un anno. Secondo GitHub, quasi l’80% dei nuovi sviluppatori usava Copilot nella prima settimana. Sono dati del fornitore, non la prova che l’IA abbia causato tutta la crescita. Mostrano però quanto l’ingresso su GitHub sia legato agli strumenti di IA.
Prima, per realizzare una piccola utilità bisognava spesso imparare abbastanza programmazione da ottenere un punto di partenza utile. Oggi si può descrivere un’idea e realizzarla gradualmente con un agente di programmazione. Le competenze restano necessarie, soprattutto con dati, autorizzazioni e sistemi in produzione. La distanza tra idea e primo programma funzionante si è comunque ridotta notevolmente.
Vedo un grande potenziale per l’open source: documentazione più chiara, nuovi test, ricerca dei difetti, interfacce più accessibili e idee abbandonate da riprendere. Sono modi concreti per accelerare lo sviluppo, non una garanzia di maggiore qualità per ogni progetto. Un repository aggiuntivo non equivale a software mantenuto, e un’altra pull request può comportare ulteriore lavoro per chi lo gestisce.
Mi interessa meno quante righe produce un agente e più quante si possano capire, verificare e mantenere. Quando il codice arriva più rapidamente, il collo di bottiglia si sposta verso persone e sistemi che decidono cosa merita di restare.
L’albero di Natale nella pagina di stato
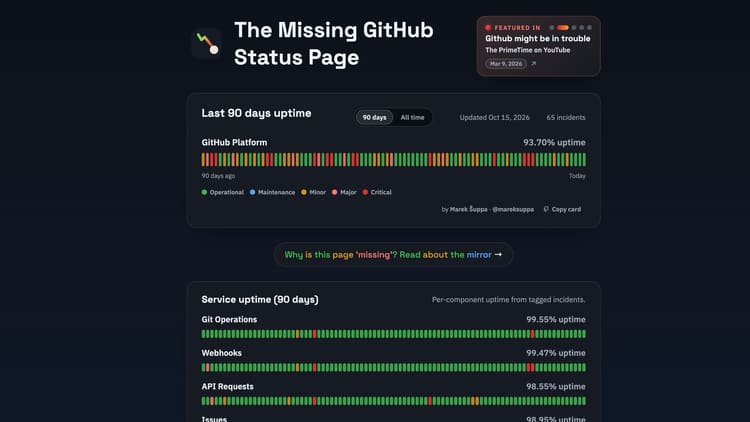
L’immagine iniziale mostra The Missing GitHub Status Page, di Marek Šuppa. La schermata del 15 ottobre 2026 riporta 65 incidenti e una disponibilità della piattaforma del 93,70% su 90 giorni. Git Operations indica invece il 99,55%. Sono numeri di quella schermata, non nuove misurazioni effettuate da me.
La pagina non ufficiale ricostruisce gli intervalli dai rapporti pubblici e unisce le interruzioni sovrapposte. Il valore complessivo aggrega servizi diversi. Non significa che clone Git, pull request e Actions fossero indisponibili contemporaneamente per tutti durante ogni incidente. Il 93,70% non diventa semplicemente «GitHub completamente offline per il 6,30% del tempo». L’interpretazione dipende dall’aggregazione e dagli incidenti inclusi.
L’immagine tocca comunque un punto sensibile. Una piattaforma di versionamento fa ormai parte della catena produttiva. Una revisione irraggiungibile, una compilazione bloccata o un’API guasta possono ritardare una pubblicazione anche con tutto il codice presente in locale. Per quel processo conta che funzioni l’intera catena.
Il grafico non dimostra neppure che questi incidenti siano stati causati dall’IA. Aiuta a capire l’interesse per le alternative. Le cause vanno valutate nei rispettivi rapporti sugli incidenti.
Perché distinguere Git da GitHub
Un’interruzione di GitHub non rivela automaticamente un difetto del modello dati di Git. Con una copia locale completa posso registrare modifiche, confrontare versioni e lavorare sui rami senza un fornitore sempre raggiungibile. Questa indipendenza è una delle caratteristiche più preziose di Git.
Diverso è il caso dei servizi costruiti intorno al repository. Se approvazioni, test, artefatti e distribuzioni dipendono da una piattaforma, la copia locale non basta a proseguire l’intero processo. Il codice è distribuito, il flusso di lavoro può essere fortemente centralizzato.
Esistono quindi due esigenze: affidabilità della piattaforma e adeguatezza del controllo delle versioni al volume e al modo di lavorare. Cambiare hosting non risolve automaticamente ogni problema di scala. Una fase difficile della piattaforma non giustifica da sola la sostituzione completa di Git.
Anthropic costruisce Scion per una scala insolita
Anthropic parla di circa 2.500 modifiche integrate al giorno a maggio 2026, salite a oltre 30.000 a settembre. La cronologia del ramo principale sfiorerebbe i 100 GB, la copia di lavoro compressa supererebbe i 25 GB. Solo la CI eseguirebbe circa 25 milioni di checkout giornalieri. Gli oltre 600 PB di trasferimenti al giorno citati sono una stima di recuperi completi ingenui, non traffico effettivamente misurato.
La risposta è Scion. Anthropic descrive una migrazione in cinque mesi, insieme allo strumento di revisione Antique e ad altre infrastrutture interne. Scion presuppone client connessi e sposta le operazioni di versionamento sul server. Carica i file secondo necessità e risponde a molte domande tramite API. Un processo non richiede così una copia locale del repository per ogni interrogazione.
Il limite indicato da Anthropic è essenziale: Scion non è un sostituto universale di Git né un GitHub pubblico annunciato per tutti. È pensato per monorepository enormi e per il carico dei propri agenti. Anthropic vuole anche condividere le lezioni con l’ecosistema Git. «Anthropic costruisce il prossimo GitHub» descrive al massimo un cambiamento tecnico, non un concorrente già disponibile.
Perché un client piccolo può fare una grande differenza
L’idea si comprende senza raggiungere quella scala. Immaginiamo un’attività automatica che verifica se un file di configurazione è cambiato tra due versioni. Serve una risposta specifica. Preparare un grande ambiente locale può costare più della verifica stessa.
Per un solo incarico la differenza può essere minima. In molti ambienti temporanei, configurazioni, trasferimenti e pulizia ripetuti possono assorbire gran parte delle risorse. Un servizio che fornisce esattamente i dati necessari cambia il conto. È una scelta architetturale, non la prova che ogni piccolo repository richieda un server centrale di versionamento.
Il prezzo è una maggiore dipendenza dalla disponibilità del servizio. Spostare lavoro sul server impone attenzione a guasti, permessi, ripristino e capacità. Avere meno dati locali è comodo finché il servizio remoto risponde.
Mi piace che un’abitudine venga rimessa in discussione. Non ne ricaverei però una raccomandazione universale. In un progetto contenuto, l’intera cronologia Git locale può offrire l’equilibrio giusto tra semplicità, velocità e indipendenza.
Cloudflare conserva Git e rende programmabili i repository
Cloudflare segue un’altra strada con Artifacts. Presentato ad aprile, offre archiviazione versionata con interfaccia compatibile Git. Le API permettono di creare, importare e duplicare repository; i normali client Git restano utilizzabili. Cloudflare propone repository distinti per progetti, attività o sessioni di agenti, con codice e contesto versionati. La base viene predisposta via software invece di configurare manualmente ogni repository come spazio permanente.
La compatibilità Git è strategicamente interessante. Strumenti esistenti e abitudini consolidate facilitano l’adozione. Un nuovo prodotto può concentrarsi sulla collaborazione senza introdurre contemporaneamente un protocollo di versionamento completamente nuovo.
A ottobre Cloudflare ha annunciato la beta aperta per clienti con un piano Workers a pagamento. Le nuove integrazioni collegano Artifacts a Workers Builds e agli ambienti di anteprima. Gli eventi possono avviare revisioni automatiche e i token per repository limitano l’accesso. Cloudflare invita esplicitamente altri a costruire la prossima piattaforma Git su Workers e Artifacts. È infrastruttura con ambizioni di piattaforma, non ancora un GitHub completo con un ecosistema sociale e organizzativo equivalente.
La differenza interessante è il confine scelto. Anthropic ottimizza il proprio enorme sistema di sviluppo. Cloudflare fornisce una base per prodotti altrui. L’interfaccia tra persone, agenti e decisioni condivise rimane una sfida di prodotto distinta.
Perché queste aziende vogliono essere lì
La motivazione direttamente documentata per Anthropic è il proprio collo di bottiglia. Ricerca e sviluppo in attesa delle operazioni di versionamento costano tempo e capacità di calcolo. Una migliore infrastruttura interna vale anche se Scion non diventerà mai pubblico.
Vedo inoltre un interesse strategico nel rendere utili gli agenti lungo processi più estesi. Un modello che scrive una funzione ha valore. Un agente che comprende il progetto, prepara modifiche verificabili e si integra con l’infrastruttura può radicarsi molto più profondamente nel lavoro quotidiano. È la mia lettura economica, non un piano commerciale di Scion confermato da Anthropic.
Per Cloudflare il legame con l’infrastruttura è più diretto. Eseguire applicazioni su Workers e conservarne i dati di sviluppo in Artifacts porta più lavoro sulla stessa piattaforma. Cloudflare indica tariffe basate su operazioni e dati archiviati. Più agenti possono significare più repository, accessi e calcolo. La convenienza di ogni flusso dipende dall’uso effettivo.
L’integrazione crea anche vincoli. Spostare un repository Git è spesso relativamente facile. Trasferire API specifiche, processi degli agenti, eventi, autorizzazioni, anteprime e distribuzioni è più complicato. Più tutto funziona comodamente insieme, più cambiare fornitore richiede sforzo.
Questi incentivi non contraddicono i benefici tecnici. Un servizio può risolvere un problema reale e rafforzare il fornitore. Proprio per questo voglio considerare entrambi gli aspetti prima che una comoda integrazione diventi una dipendenza che nessuno mette in discussione.
Il codice contiene più del testo del programma
E sì, i dati di addestramento fanno parte della discussione. Meritano attenzione come possibile interesse strategico. Usarli per spiegare ogni nuova piattaforma Git sarebbe troppo facile.
Un repository contiene spesso molto più della soluzione attuale. La cronologia può mostrare il primo approccio, il test fallito, il motivo di un rifiuto in revisione e la correzione accettata. Per sviluppare sistemi di programmazione questa relazione può essere preziosa: compito, tentativo, riscontro e risultato verificabile sono collegati.
Prendiamo un esempio inventato. Un agente corregge un calcolo di date. Il primo tentativo supera i test esistenti ma fallisce una nuova prova sul cambio d’anno. Un revisore spiega l’ipotesi sbagliata e la modifica successiva la corregge. Il valore didattico risiederebbe anche nel percorso dall’errore plausibile alla soluzione motivata. Se un fornitore usi davvero quei dati e ne abbia il diritto è una questione separata.
Il valore del codice non scompare perché generarlo costa meno. Requisiti affidabili, decisioni documentate, test validi, esperienza di manutenzione e funzionamento dimostrato richiedono ancora lavoro. Una montagna di file generati non li sostituisce. Quando le proposte possono essere infinite, acquista valore la prova che una risolva davvero il problema.
Questa è la mia valutazione del potenziale economico e tecnico. Gli annunci discussi non provano che Anthropic raccolga repository privati altrui attraverso Scion né che Cloudflare usi Artifacts per addestrare un proprio modello di programmazione.
Cosa distinguere davvero nell’addestramento
L’interesse dell’IA per i dati di sviluppo non è solo teorico. A marzo 2026 GitHub ha annunciato che dal 24 aprile avrebbe usato le interazioni di alcuni piani personali Copilot per l’addestramento, salvo opposizione. Distingue espressamente le interazioni attive dai contenuti privati archiviati a riposo, che non verrebbero letti indiscriminatamente a tale scopo. Copilot Business ed Enterprise hanno protezioni diverse. GitHub Copilot
Anthropic afferma invece di non usare per impostazione predefinita input e output dei prodotti commerciali per l’addestramento. Feedback volontari e partecipazione esplicita a determinati programmi possono essere trattati diversamente. Non è una promessa generale per tutti i piani personali e tutte le impostazioni. Anthropic
Per un nuovo servizio vorrei sapere quali contenuti sono solo archiviati, quali elaborati per rispondere e quali usati per miglioramenti o addestramento. Sono attività diverse. Elaborare codice per lavorarci non concede automaticamente il diritto di incorporarlo stabilmente in un modello.
Neppure la definizione open source risolve ogni domanda sull’utilizzo. Visibilità pubblica, licenza, informazioni riservate e condizioni del servizio vanno distinte. Una politica dati comprensibile è parte del prodotto quanto un’API utile.
Il prossimo GitHub deve permettere decisioni migliori
La visione più comoda sarebbe una piattaforma dove infiniti agenti producono codice senza limiti e altri lo approvano automaticamente. Non mi convince. Se più sistemi condividono la stessa ipotesi sbagliata, il loro accordo non costituisce una verifica indipendente.
Una piattaforma utile dovrebbe chiarire quale incarico soddisfa una modifica, da quale versione parte, quali controlli sono stati eseguiti e chi risponde dell’accettazione. Modifiche parallele possono sembrare corrette separatamente e rompere qualcosa insieme. Un merge più veloce non elimina il problema.
Anche il contesto degli agenti richiede confini. Descrizioni, registri e configurazioni possono contenere informazioni inadatte a qualunque repository o ambiente esterno. Conservare le sessioni crea un nuovo patrimonio di dati oltre all’aiuto allo sviluppo. Accesso e durata richiedono una scelta consapevole.
Per l’open source resta essenziale il lato umano: fiducia nei manutentori, discussioni comprensibili e volontà di seguire un progetto per anni. Un hosting più rapido può sostenere tutto questo. Più attività automatica, da sola, non può sostituirlo.
GitHub è sfidato, ma la successione resta aperta
Trovo sano rimettere in discussione anche gli strumenti fondamentali. Se l’IA consente a più persone di creare software, possiamo chiederci se le piattaforme attuali siano ancora adatte al lavoro che ne deriva.
Anthropic mostra una ricostruzione interna specializzata. Cloudflare apre infrastruttura a nuovi prodotti. GitHub conserva un ecosistema che un’alternativa dovrebbe sostituire o integrare utilmente. Una nuova architettura di archiviazione non deciderà da sola questa competizione.
Per me conta chi consentirà a più persone e agenti di collaborare produttivamente senza perdere tracciabilità, indipendenza e controllo dei dati. È questo il metro per il prossimo GitHub. Ed è probabilmente anche dove si trova una parte considerevole del business.
Alla prossima,
Joe